Sushil Awale
Wissenschaftlicher Mitarbeiter, Forschungsgruppe Visual Analytics, TIB.

Ich bin wissenschaftlicher Mitarbeiter in der Forschungsgruppe Visual Analytics der TIB in Hannover und Doktorand an der Leibniz Universität Hannover. Seit Dezember 2025 bin ich außerdem wissenschaftlicher Mitarbeiter im Team Multimodal Modelling and Machine Learning (M3L) an der Universität Marburg. Betreut wird meine Promotion von Prof. Dr. Ralph Ewerth.
In meiner Forschung beschäftige ich mich mit multimodalem Information Retrieval für wissenschaftliche, technische und kulturelle Bereiche. Ich entwickle Suchsysteme auf Basis von Vision-Language-Modellen, die die Recherche in Patenten unterstützen und den Zugang zu Kulturerbe verbessern. Außerdem interessiere ich mich für Domänenanpassung für bessere multimodale Repräsentationen, Wissensgraphen und Natural Language Processing.
Zuvor habe ich als studentische Hilfskraft in der Language Technology Group der Universität Hamburg an einem intelligenten System für wissenschaftliche Literatur auf Basis von Natural Language Processing (NLP) gearbeitet.
Meinen Master in Machine Learning habe ich 2023 an der Universität Hamburg abgeschlossen, meinen Bachelor in Informatik 2020 an der Tribhuvan University in Nepal.
Neuigkeiten
- Unser Panel Photographs from Colonial Contexts in Cultural Heritage Collections. AI-Supported Approaches to Sensitive Image and Text Contents wurde für die DHD 2027 (Digital Humanities im deutschsprachigen Raum) angenommen.
- Auszeichnung Unser Paper Examining Gender and Racial Bias in Vision-language Models within Colonial Contexts (Awale et al., WebSci 2026) wurde auf der ACM Web Science Conference 2026 mit dem Best Poster Paper Award ausgezeichnet.
- Unser Paper Examining Gender and Racial Bias in Vision-language Models within Colonial Contexts (Awale et al., WebSci 2026) wurde als Poster-Paper auf der ACM Web Science Conference 2026 angenommen.
- Beginn meiner Tätigkeit als wissenschaftlicher Mitarbeiter im Team Multimodal Modelling and Machine Learning (M3L) an der Universität Marburg, zusätzlich zu meiner Stelle an der TIB.
- Ganztägiges Praxis-Tutorial mit Eric Müller-Budack zum Thema Fusing Vision and Language: A Tutorial on Vision-Language Models for Multimodal Content Analysis auf der KONVENS 2025 in Hildesheim. Folien und Materialien gibt es hier.
ausgewählte Publikationen
- WebSciIn ACM Web Science Conference Companion, WebSci 2026, Braunschweig, Germany, May 26-29, 2026, May 2026
- PatentSemTech
 In Patent Text Mining and Semantic Technologies co-located with the ACM SIGIR Conference on Research and Development in Information Retrieval, PatentSemTech@SIGIR 2025, Padua, Italy, July 17, 2025, Jul 2025
Code & Projekte
iPatent
PatentSemTech @ SIGIR 2025
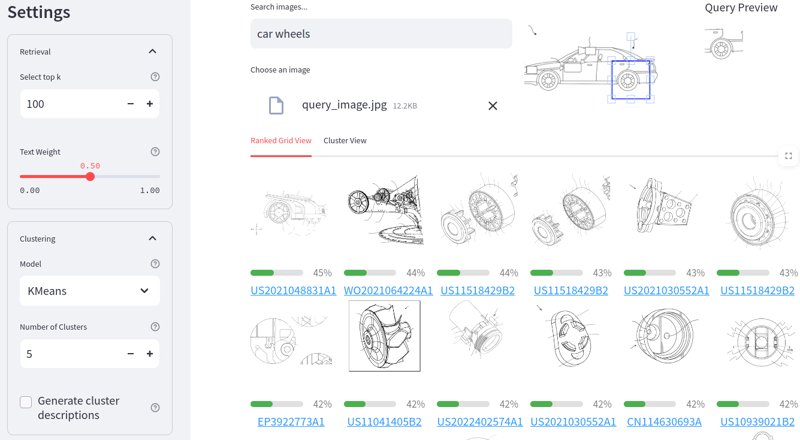
Interaktives Suchsystem für die multimodale Suche und Interpretation von Patentbildern, mit Clustering zur Exploration der Ergebnisse. Live-Demo an der TIB.
Patent Figure Classification
ECIR 2025
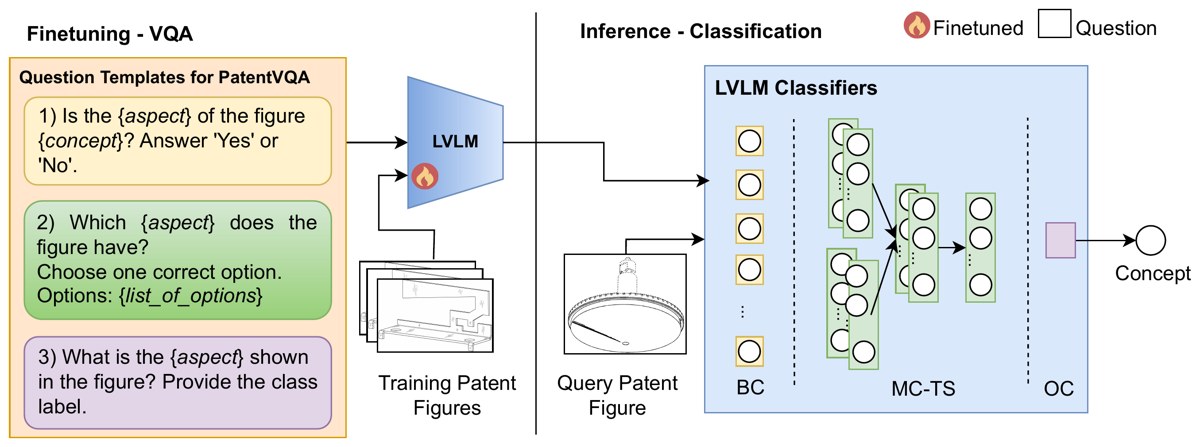
Code und die Datensätze PatFigCLS / PatFigVQA zur Klassifikation von Patentzeichnungen nach Typ, Projektion, Patentklasse und Objekt mit großen Vision-Language-Modellen, einschließlich einer turnierartigen Multiple-Choice-Strategie für große Label-Mengen.
CARA
Software, 2026
Open-Source-Werkzeug für Relevanzbewertungen beim Aufbau von Testkollektionen im Bild-Retrieval. Bewertet wird in Gruppen ähnlicher Bilder; ein integrierter Simulator vergleicht Gruppierungseinstellungen vor Beginn einer Studie.
Colonial-Context VLM Bias Dataset
WebSci 2026
Annotierte historische Fotografien, mit denen sich Gender- und Hautfarben-Bias von Vision-Language-Modellen bei der Suche in Archivbeständen messen lässt.
Fusing Vision and Language Tutorial
KONVENS 2025
Ganztägiges Praxis-Tutorial zu Vision-Language-Modellen für die multimodale Inhaltsanalyse, mit Folien und Notebooks.
DBLP-QuAD
BIR @ ECIR 2023
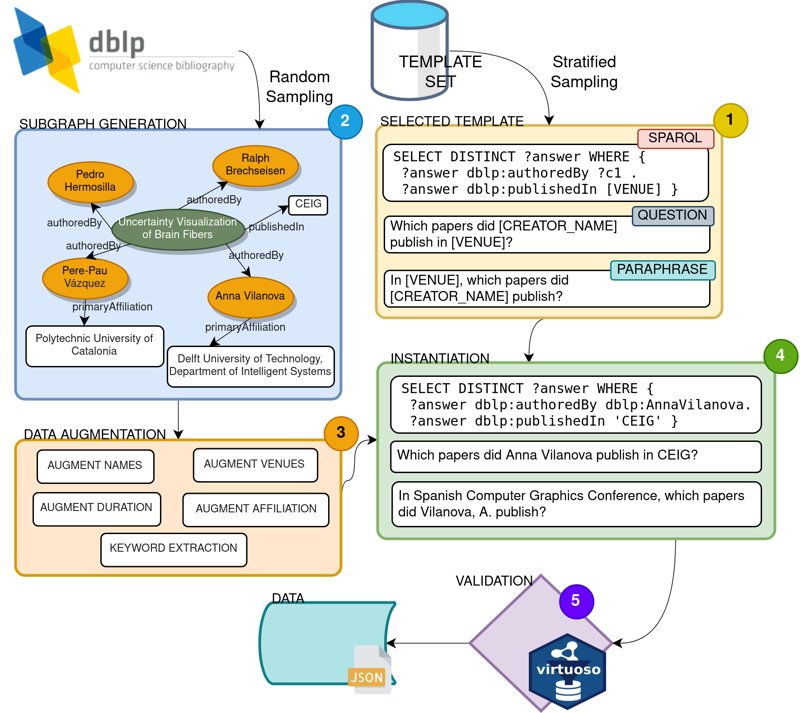
10.000 Frage-Antwort-Paare mit SPARQL-Abfragen über den wissenschaftlichen Wissensgraphen DBLP, für Question Answering über Wissensgraphen.